
Sure, you can handle it. But should you?
Let our experts manage the tech maintenance while you focus on your business.
Let our experts manage the tech maintenance while you focus on your business.
Konfiguration
Connector für GraphQL
Einleitung
Der Connector für GraphQL verbindet die GraphQL API mit der Suche in Mindbreeze InSpire. Dies ermöglicht die Nutzung von Elementen, die über GraphQL abgerufen wurden, in Mindbreeze Insight Apps. Der Connector iteriert über alle von der GraphQL-API abgerufenen Objekte und transformiert diese zu indexierbare Entitäten für den Mindbreeze Suchindex.
Administratoren können sofort mit der Konfiguration beginnen, da der Connector für GraphQL standardmäßig in Mindbreeze InSpire enthalten ist.
Kernkonzepte
Datenerfassung
Authentifizierung: Der Connector übernimmt den notwendigen Security-Handshake für den Zugriff auf den GraphQL-Endpunkt, um autorisierte Datenabfragen zu gewährleisten.
GraphQL Abfragen: Der Connector verwendet konfigurierbare GraphQL-Queries, um exakt zu definieren, welche Felder und Beziehungen abgerufen werden sollen.
Pagination: Um große Datensätze zu bewältigen, implementiert der Connector eine Pagination-Logik, die die Ergebnismengen iteriert, um sicherzustellen, dass alle verfügbaren Objekte gefunden und indiziert werden.
Objekte: Jedes einzelne Objekt, dass von der GraphQL-Abfrage zurückgegeben wird (z.B.: ein Benutzer, ein Produkt oder ein Dokument), wird als einzelnes Objekt behandelt und einem einzelnen Mindbreeze Dokument zugeordnet.
Datentransformation & Extraktion
JSONPath: Der Connector nutzt die JSONPath Syntax (RFC 9535). Dies ermöglicht es Administratoren den Pfad zu einem bestimmten Wert (z.B. $.user.profile.email) über die Konfiguration zu definieren.
JSONPointer (veraltet): Der Connector unterstützt die JSONPointer Syntax (RFC 6901). Dies ermöglicht es Administratoren den Pfad zu einem bestimmten Wert
(z.B. /user/profile/email) über die Konfiguration zu definieren.
Pivotieren: Ein Normalisierungsschritt, der Arrays aus Schlüssel-Wert-Paaren in Objekte umwandelt. Dies vereinfacht die anschließende Extraktion von Metadaten.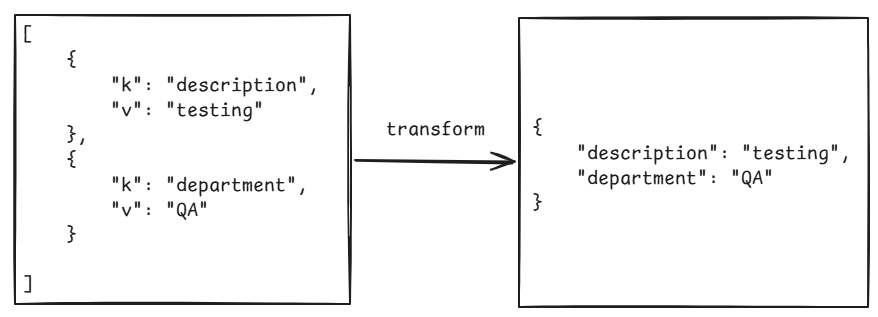
Metadaten Extraktion: Alle Daten eines Objekts werden extrahiert und als Metadaten gespeichert. Komplexe Metadaten werden ausgeflacht, um den Zugriff zu erleichtern.
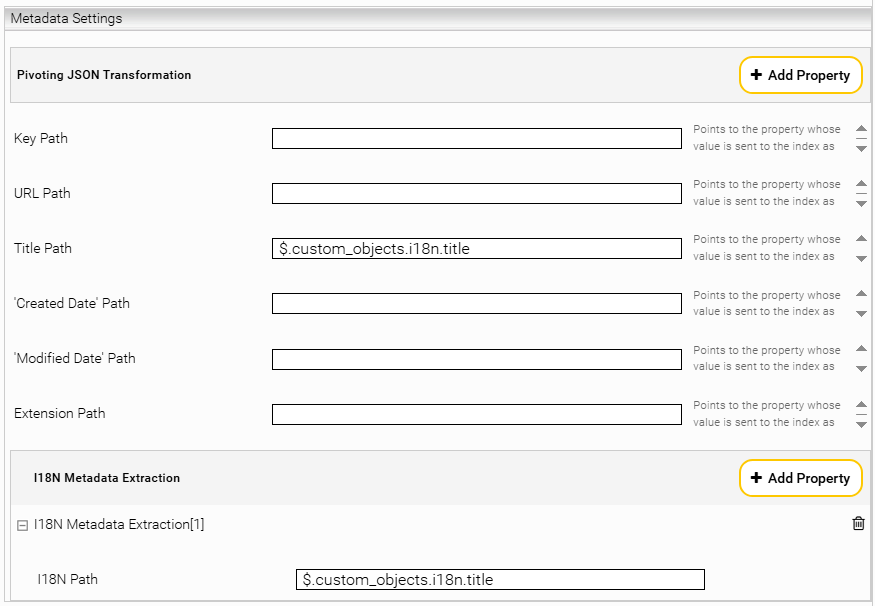
I18n Metadaten Extraktion: i18n Metadaten werden aus mehrsprachigen Feldern extrahiert, sodass die Metadaten in der korrekten Sprache an die Benutzer angezeigt werden können.
Ausflachen: JSON-Strukturen werden rekursiv durchlaufen und werden in durch unterstrich-getrennte Metadaten umgewandelt. (z.B.: address_city). Dabei werden verschachtelte Daten in einfache Metadaten überführt, um den Zugriff zu erleichtern.
ACL (Zugriffskontrolle): Der Connector extrahiert aus dem JSON, Eigenschaften, die sowohl als GRANT- als auch DENY-Berechtigungen gesetzt werden können. So wird sichergestellt, dass nur autorisierte Benutzer die jeweiligen Dokumente finden können.
Datenverarbeitungspipeline
Der Crawler steuert den Abruf von Daten aus einer GraphQL-API und transformiert diese über eine sequenzielle Pipeline aus Metadaten-Anreicherung und Ausflachung in indizierte Dokumente.
- Authentifizierung: Abruf eines OAuth-Tokens zur Autorisierung der API-Abfragen.
- Datenabruf: Abfrage von Objekten aus GraphQL mithilfe einer definierten Query.
- Pagination: Große Ergebnismengen können mittels Offset, Cursor oder „Single Page Retrieval“ abgerufen werden. Beachten Sie, dass dies unabhängig gehandhabt wird, daher kann keine Pivotierung auf die von der API zurückgegebenen JSON-Elemente angewendet werden.
- Objekt Verarbeitung: Iteration über jedes abgerufene Objekt und Ausführung der folgenden Sequenz:
- Pivotieren: Durchführung sequentieller Datentransformationen, bei denen jeder Schritt auf dem vorherigen aufbaut.
- Zuweisung der Hauptmetadaten: Festlegung der primären Metadaten basierend auf den Ergebnissen der Pivotierung.
- Zuweisung der ACL-Metadaten: Definition von ACLs basierend auf den Ergebnissen der Pivotierung.
- I18n Extraktion: Extraktion von i18n Metadaten basierend auf den Ergebnissen der Pivotierung.
- Mindbreeze Item Metadaten / Ausflachen: Konvertierung verschachtelter Strukturen in einfache, flache Metadaten und in Mindbreeze Item Metadaten.
- Indizierung: Übermittlung des final verarbeiteten Dokuments and den Index.
Konfiguration von Mindbreeze
In diesem Kapitel wird die Basiskonfiguration des GraphQL Konnektors in einem Quickstart-Guide erklärt. Zusätzliche Informationen zu Ihrem spezifischen Anwendungsfall finden Sie in der Übersicht aller Einstellungen in den kommenden Kapiteln.
Quickstart-Guide
Schritt 1: Index erstellen
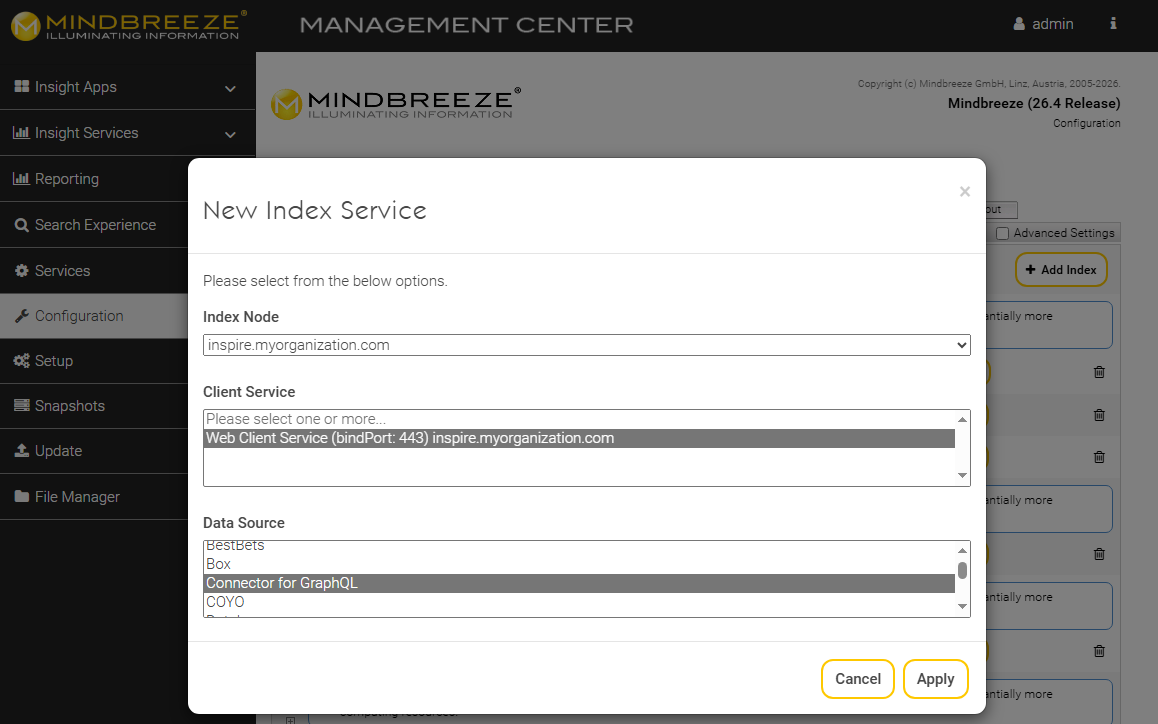
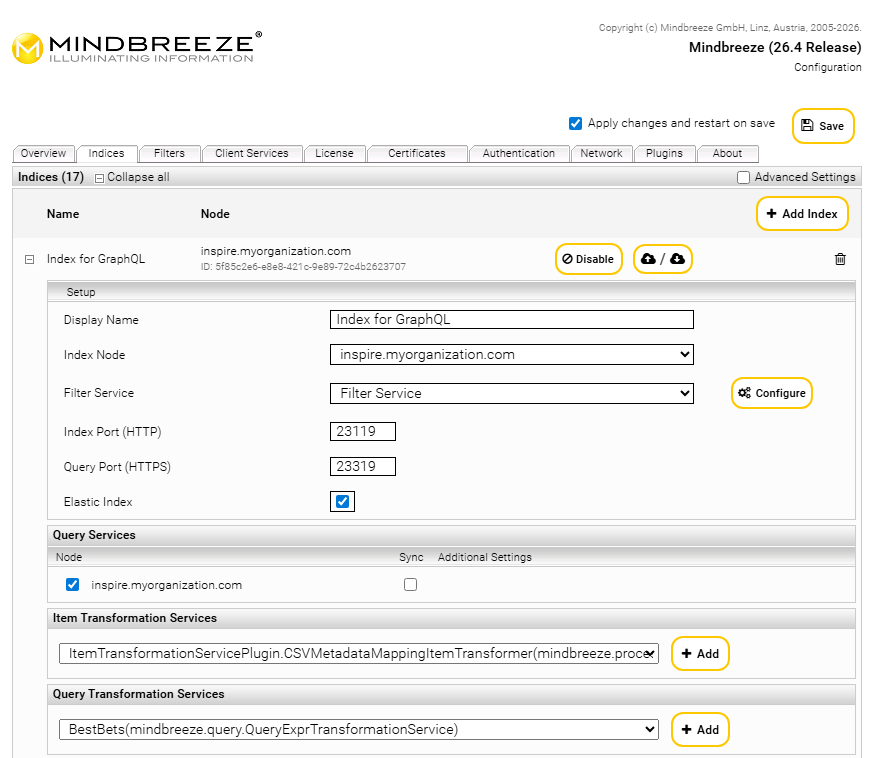
Im Tab „Indices“ über die Schaltfläche „+ Add Index“ einen neuen Index hinzufügen. Den gewünschten „Index Node“ und „Client Service“ auswählen und als „Data Source“ die Option „Connector for GraphQL“ wählen. Die Eingaben anschließend mit „Apply“ bestätigen.
Schritt 2: Konfiguration der Datenquelle
Im nächsten Schritt wird die Datenquelle im Bereich „Data Sources“ konfiguriert.
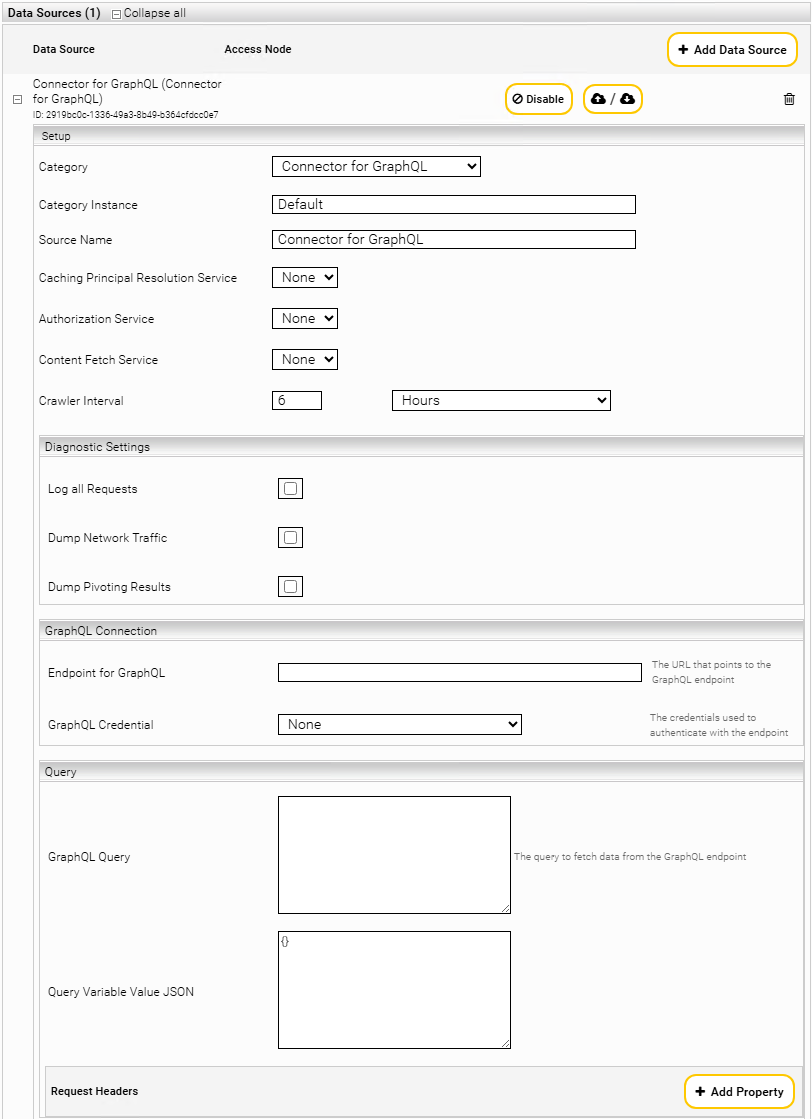
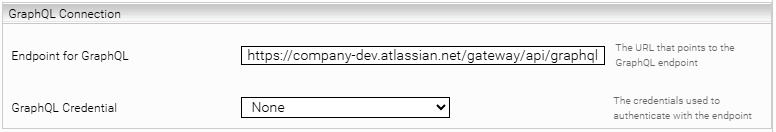
Um die Basiskonfiguration zu erstellen, müssen die folgenden Einstellungen in den entsprechenden Abschnitten gesetzt werden:
Einstellung | Beispiel |
Endpoint for GraphQL | https://company-dev.atlassian.net/gateway/api/graphql |
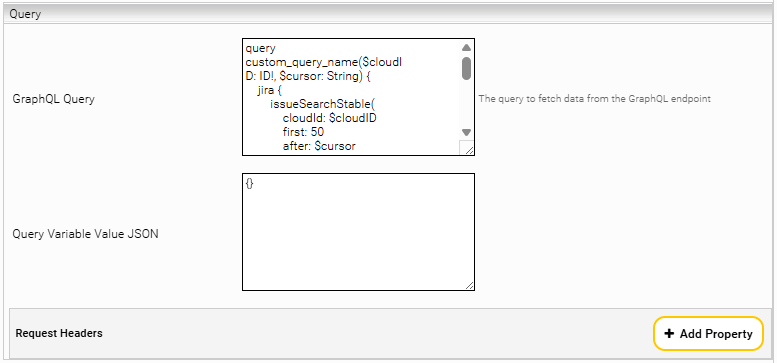
Einstellung | Beispiel |
GraphQL Query | query custom_query_name($cloudID: ID!, $cursor: String) { |
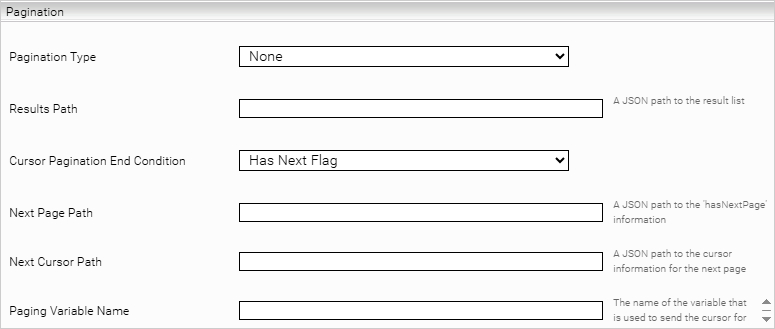
Einstellung | Beispiel |
Pagination Type | Wählen Sie den zu verwendenden Paginierungstyp:
|
Results Path | Cursor-basierte Paginierung: $.data.jira.issueSearchStable.edges Offset-basierte Paginierung: $.data.GlideRecord_Query.kb_knowledge[‘_results’] |
Cursor Pagination End Condition | Nur erforderlich, wenn die Einstellung „Pagination Type“ auf die Option „Cursor“ gesetzt ist. Die folgenden Optionen sind verfügbar:
|
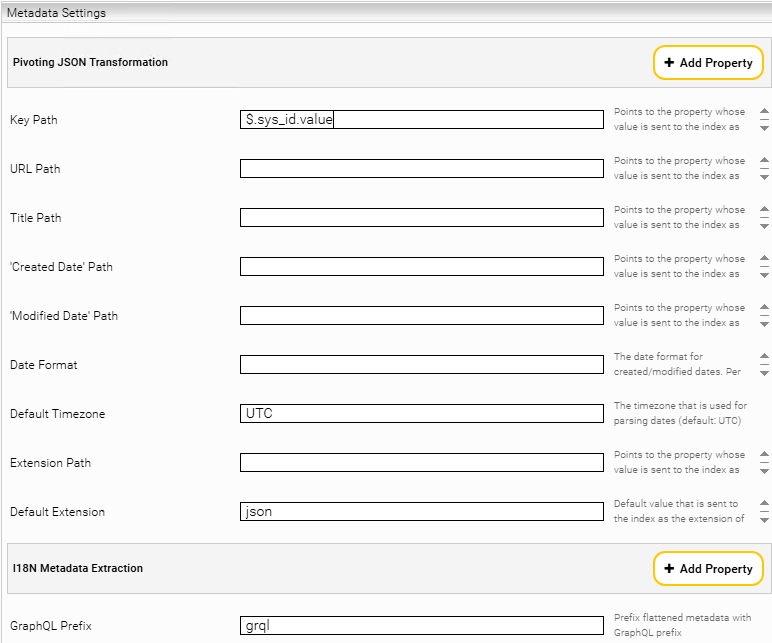
Einstellung | Beispiel |
Key Path | $.sys_id.value |
Speichern Sie die Konfiguration mit „Save“. Die Basiskonfiguration für den Connector für GraphQL ist nun abgeschlossen.
Verfügbare Einstellungen
Abschnitt „Performance Settings“ (Erweiterte Einstellungen)
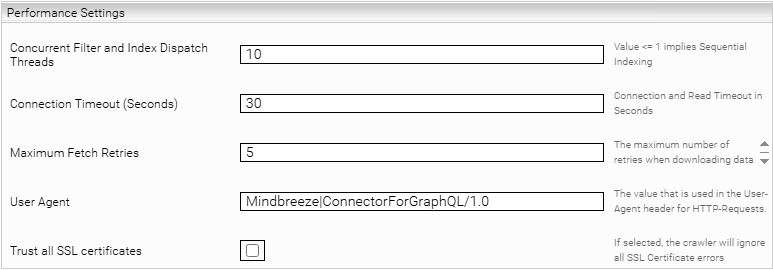
Einstellung | Beschreibung | Standardeinstellung / Beispiel |
Concurrent Filter and Index Dispatch Threads | Anzahl der Threads, die Daten an den Filter- und Index-Service senden. Wenn die Anzahl kleiner oder gleich null ist, erfolgt die Übermittlung seriell. | 10 |
Connection Timeout (Seconds) | Legt in Sekunden fest, wie lange der Connector auf eine Antwort wartet, bevor der API-Aufruf abgebrochen wird. | 30 |
Maximum Fetch Retries | Legt die maximale Anzahl an Wiederholungsversuchen fest, die unternommen werden, wenn der Server bestimmte Drosselungs-Antworten (z. B. 429) sendet. | 5 |
User Agent | Legt den User-Agent-Header fest, der für API-Aufrufe verwendet werden soll. | NON|SV|Mindbreeze|ConnectorForGraphQL/1.0 |
Trust all SSL certificates | Ermöglicht die Verwendung von ungesicherten Verbindungen. Dies kann beispielsweise für Testsysteme verwendet werden. Achtung: Darf in der Produktionsumgebung nicht aktiviert werden. | Deaktiviert |
Abschnitt „Diagnostic Settings“
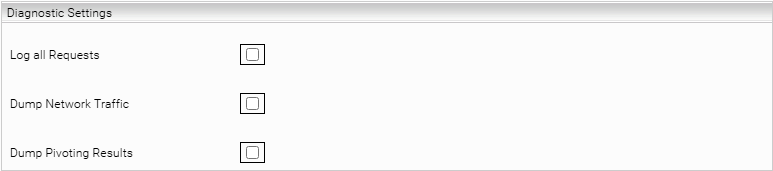
Einstellung | Beschreibung | Standardeinstellung / Beispiel |
Log all Requests | Wenn diese Einstellung aktiviert ist, werden alle Anfragen an die GraphQL-API in einer Datei namens „request-log.csv“ protokolliert. | Deaktiviert |
Dump Network Traffic | Wenn diese Einstellung aktiviert ist, speichert das System für jede GraphQL-Netzwerkanfrage eine Log-Datei, die den vollständigen Request, die Response-Bodys sowie die Header enthält. Achtung: Bitte beachten Sie, dass auch sensible Daten, wie z. B. Authentifizierungs-Header, in die Network-Dump-Dateien geschrieben werden können. | Deaktiviert |
Dump Pivoting Results | Wenn diese Einstellung aktiviert ist, werden die einzelnen Zwischenschritte der Metadaten Pivotierung im Ordner „pivoting-dump“ protokolliert. | Deaktiviert |
Abschnitt „GraphQL Connection“
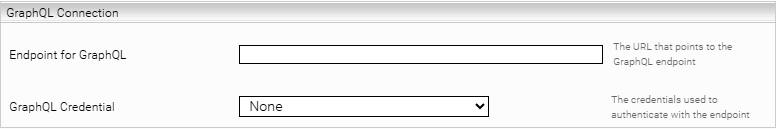
Einstellung | Beschreibung | Standardeinstellung / Beispiel | ||||||||
Endpoint for GraphQL | Legt die URL fest, an die GraphQL-Abfragen gesendet werden. Hinweis: Die Struktur des Endpunkts ist abhängig von der verwendeten Datenquelle, wie in der Spalte „Standardeinstellung/Beispiel“ dargestellt. | Beispiel eines ServiceNow Endpoints: https://dev123456.service-now.com/now/nav/ui/classic/params/target/graphql-explorer.do Beispiel eines Atlassian Jira Endpoints: https://company-dev.atlassian.net/gateway/api/graphql | ||||||||
GraphQL Credential | Legt die Credentials fest, die zur Authentifizierung von Anfragen an den GraphQL-Endpunkt verwendet werden. Die folgenden Typen von Credentials werden unterstützt:
| Standardeinstellung: |
Abschnitt „Query“
Einstellung | Beschreibung | Standardeinstellung / Beispiel |
GraphQL Query | Definiert die GraphQL query. | Query-Beispiele sind in den Kapiteln Cursor-basierte Paginierung und Offset-basierte Paginierung verfügbar. |
Query Variable Value JSON | Definiert die Query Variablen für die GraphQL-Abfrage benötigt werden. | {“limit“:3}
|
Request Headers | Definiert die Header, die an den GraphQL-Endpunkt gesendet werden. | "X-ExperimentalApi": "JiraIssueSearch" |
Abschnitt „Pagination“
Einstellung | Beschreibung | Standardeinstellung / Beispiel | ||||||||
Pagination Type* | Diese Einstellung legt den Paginierungstypen fest und ob die Abfrage eine cursor-basierte oder offset-basierte Paginierung verwendet. Folgende Optionen stehen zur Verfügung:
| None | ||||||||
Results Path* | Ein JSON-Path zum JSON-Wert, der die Resultate definiert. | Cursor-basierte Paginierung: $.data.jira.issueSearchStable.edges Offset-basierte Paginierung: $.data.GlideRecord_Query.kb_knowledge[‘_results’] | ||||||||
Cursor pagination End Condition* | Diese Einstellung definiert die Bedingung, anhand derer ermittelt wird, wann alle verfügbaren Dokumente abgerufen wurden Hinweis: Wird nicht mit Offset-Paginierung unterstützt.
| Standardeinstellung: “Has Next Flag” Optionen: | ||||||||
Next Page Path | Ein JSON-Path zum JSON-Wert, der definiert, ob es eine nächste Seite gibt | Beispiel: $.data.jira.issueSearchStable.pageInfo.hasNextPage Weitere Informationen finden Sie in der Mindbreeze Konfiguration für die Cursor-basierte Paginierung. | ||||||||
Next Cursor Path | Ein JSON-Path zum JSON-Wert, der den nächsten Cursor definiert | Beispiel: $.data.jira.issueSearchStable.pageInfo.endCursor Weitere Informationen finden Sie in der Mindbreeze Konfiguration für die Cursor-basierte Paginierung. | ||||||||
Paging Variable Name | Definiert die Variable, die mit der Abfrage gesendet wird, um die Iteration der nächsten Seite zu steuern. Die zu definierende Variable hängt von der konfigurierten Abfrage und deren Eigenschaften ab. | Cursor-basierte Paginierung: cursor Offset-basierte Paginierung: offset |
Abschnitt: „Metadata Settings“
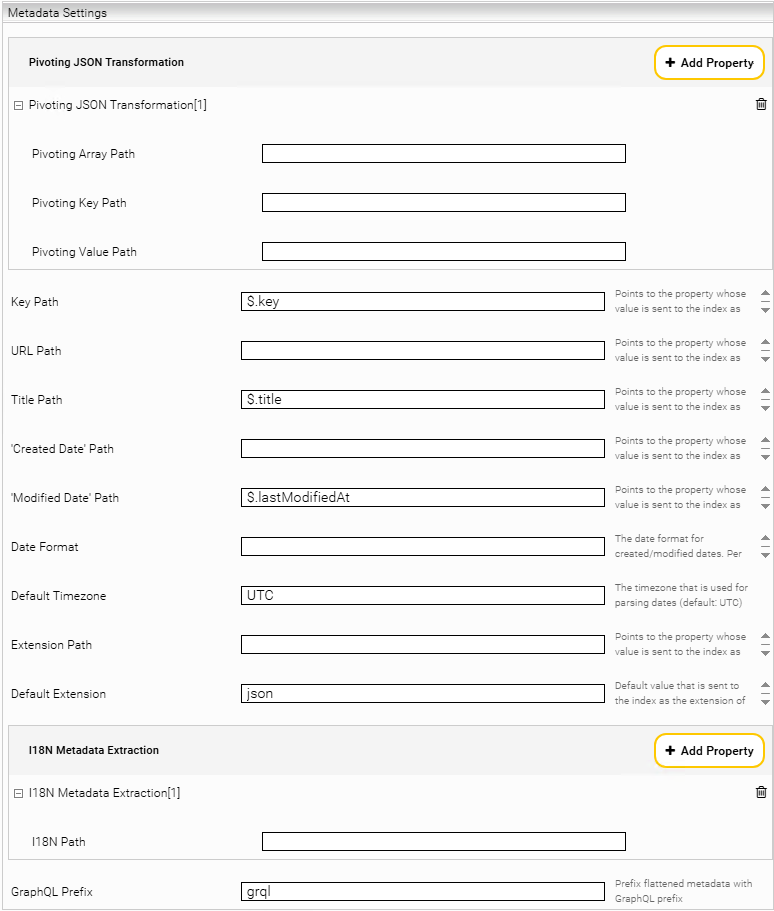
Einstellung | Beschreibung | Standardeinstellung / Beispiel | ||||||||
Pivoting JSON Transformation | Ein JSON-Path zum JSON-Array das pivotiert werden soll.
| Siehe das Kapitel Beispiele für Pivotierung. | ||||||||
Key Path* | Ein JSON-Path zum JSON-Wert, der als eindeutiger Schlüssel für Mindbreeze-Dokumente dient, die vom Connector an den Mindbreeze Filter- und Index-Service gesendet werden. | Beispiel: $.sys_id.value Weitere Informationen finden Sie im Code-Beispiel im „Ergebnis“-Kapitel im Kapitel Offset-basierte Paginierung. | ||||||||
URL Path | Ein JSON-Path zum JSON-Wert, der als Mindbreeze-Dokument-URL verwendet werden soll. | Beispiel: $.url.value | ||||||||
Title Path | Ein JSON-Path zum JSON-Wert, der den Titel des Dokuments definiert. Falls der Titel ein i18n Metadatum sein soll, muss derselbe Pfad bei der Einstellung „I18N Metadata Extraction“ eingetragen werden. | Beispiel: $.text.value Weitere Informationen finden Sie im Code-Beispiel im „Ergebnis“-Kapitel im Kapitel Offset-basierte Paginierung. | ||||||||
‘Created Date’ Path | Ein JSON-Path zum JSON-Wert, der das Erstellungsdatum des Dokuments festlegt. | Beispiel: $.sys_created_on.value Weitere Informationen finden Sie im Code-Beispiel im „Ergebnis“-Kapitel im Kapitel Offset-basierte Paginierung. | ||||||||
‘Modified Date’ Path | Ein JSON-Path zum JSON-Wert, der das Datum der letzten Änderung des Dokuments angibt. | Beispiel: $.sys_updated_on.value Weitere Informationen finden Sie im Code-Beispiel im „Ergebnis“-Kapitel im Kapitel Offset-basierte Paginierung. | ||||||||
Date Format | Das Datumsmuster, das zum Parsen der Werte verwendet wird, die über die Pfade für das Erstellungs- und Änderungsdatum bereitgestellt werden.
| Beispiel: MM-dd'T'HH:mm'Z' | ||||||||
Default Timezone | Die Standardzeitzone, die zum Parsen von Datumsangaben ohne Zeitzone verwendet wird. | Beispiel: America/Phoenix UTC | ||||||||
Extension Path | Ein JSON-Path zum JSON-Wert, der das Dateiformat für das Dokument definiert. | Beispiel: $.extension.value | ||||||||
Default Extension | Das Fallback-Dateiformat, das verwendet wird, wenn die vorherige Einstellung „Extension Path“ nicht konfiguriert ist oder wenn das JSON nicht den erforderlichen Wert enthält. | Standardeinstellung: Json | ||||||||
I18N Metadata Extraction | Definiert die Metadaten, die die i18n-Werte enthalten. Falls die Daten als JSON-Array bereitgestellt werden, müssen diese zuerst pivotiert werden. Alle Schlüssel und Werte müssen Strings sein, und die Schlüssel müssen dem ISO-639-Standard entsprechen.
| Siehe Beispiele im Kapitel Beispiele für i18n. | ||||||||
GraphQL Prefix (Advanced Settings) | Diese Einstellung setzt ein GraphQL-Präfix vor die Metadaten. | Standardeinstellung: grql |
Abschnitt „Content Settings“
Die Inhalte für die Dokumente werden durch den JSONFilter bereitgestellt.
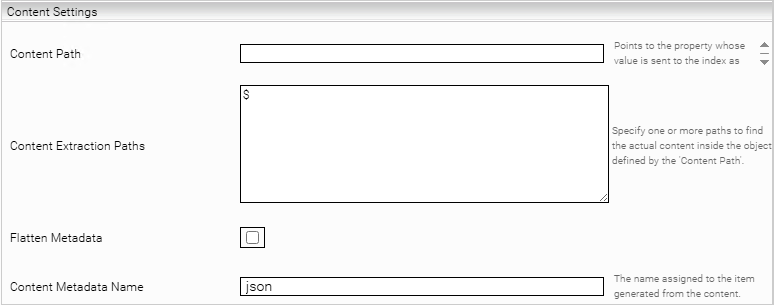
Einstellung | Beschreibung | Standardeinstellung / Beispiel |
Content Path | Ein JSON-Path zum Objekt, das den Inhalt enthält. | Beispiel: $.document.content |
Content Extraction Paths | Mehrere JSON-Pfade, die durch Zeilenumbrüche getrennt sind und den Inhalt im JSON-Objekt lokalisieren, das durch die Einstellung „Content Path“ angegebenen ist. | Standardeinstellung: $ (everything) |
Flatten Metadata | Ist diese Einstellung aktiviert, werden die Metadaten für das angegebene Objekt ausgeflacht, das durch die Einstellung „Content Path“ angegebenen ist. | Standardeinstellung: false |
Content Metadata Name | Der Name für das Item Metadatum, das vom JSONFilter bereitgestellt wird. | Standardeinstellung: json |
Abschnitt „ACL Settings“
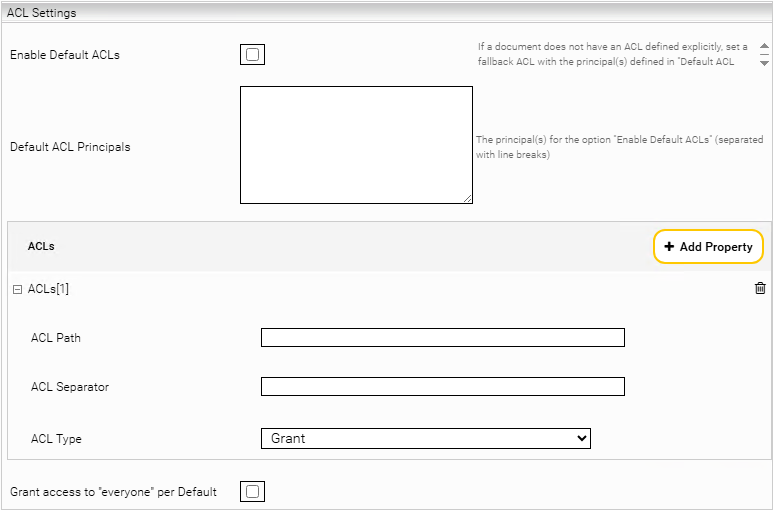
Einstellung | Beschreibung | Standardeinstellung / Beispiel | ||||||||
Enable Default ACLs | Wenn diese Einstellung aktiviert ist, werden die Default-Principals aus der nachfolgenden Einstellung „Default ACL Principals“ als GRANT-Berechtigungen für alle Dokumente hinzugefügt. Die Principals werden durch Zeilenumbrüche getrennt. | Standardeinstellung: Deaktiviert | ||||||||
Default ACL Principals | Definiert die Principals, die als GRANT Berechtigungen dem Dokument hinzugefügt werden. | Beispiel: marketing_group developer_group | ||||||||
ACLs | Legt die Eigenschaft fest, die zur Befüllung der Zugriffskontrollliste (ACL) verwendet wird.
| Hinweis: | ||||||||
Grant access to ‘everyone’ per Default | Wenn diese Einstellung aktiviert ist, wird standardmäßig allen Benutzern der Zugriff auf die Suchergebnisse gewährt. Dies kann für öffentliche Daten nützlich sein. | Standardeinstellung: Deaktiviert |
Beispiele für cursor-basierte und offset-basierte Paginierung
Cursor-basierte Paginierung
Die folgenden Beispiele verwenden Abfragen und Antworten aus Atlassian Jira zu Veranschaulichungszwecken.
Bitte beachten Sie, dass es sich hierbei lediglich um ein Beispiel handelt. Für tatsächliche Crawling-Anwendungsfälle in der Produktion, verwenden Sie bitte stattdessen den dedizierten Mindbreeze Atlassian Jira Connector, um Jira-Dokumente zu crawlen.
Query
Die folgende Query bzw. Abfrage ist definiert:
query custom_query_name($cloudID: ID!, $cursor: String) {
jira {
issueSearchStable(
cloudId: $cloudID
first: 50
after: $cursor
issueSearchInput: {jql: "project = 'DEV'"}
){
totalCount
edges {
node {
summary
}
}
pageInfo {
hasNextPage
endCursor
}
}
}
}
Die folgenden Konfigurationsoptionen sind im definierten Query:
Konfigurationsoption | Ist im Query definiert als… |
Query variables | cloudID |
Paging variable name | cursor |
Results path | edges |
Next page path / Next cursor path | hasNextPage endCursor |
Ergebnis
Um zu sehen, ob das definierte Query auch das benötigte Ergebnis erzeugt, kann ein beliebiger GraphQL Explorer verwendet werden. Basierend darauf wie das Query definiert ist, werden folgende Query-Variable und Header auch noch benötigt:
Query variable | {„cloudID“: „my-organization-1234“} |
Headers | {"X-ExperimentalApi" : "JiraIssueSearch"} |
Das Ergebnis sieht dann so aus:
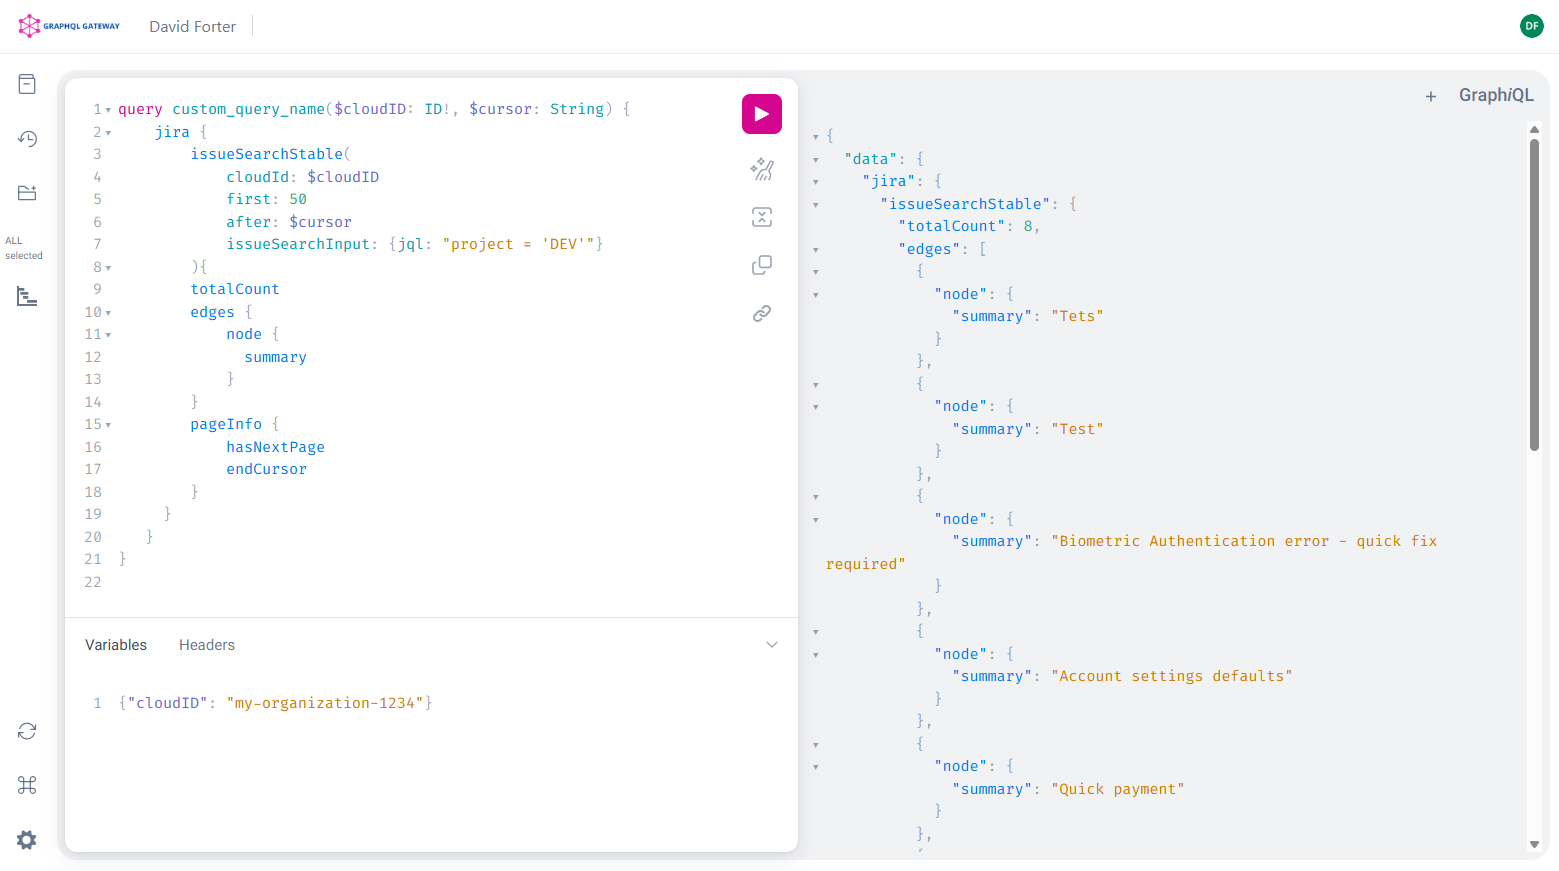
Da das definierte Query die erwarteten Ergebnisse ausgibt, ist der nächste Schritt die Konfiguration des Query und der Cursor-basierten Paginierung in Mindbreeze InSpire.
Mindbreeze Konfiguration
Um die definierte Query und die Cursor-basierte Paginierung in Mindbreeze InSpire vollständig zu konfigurieren, müssen die folgenden Einstellungen in den folgenden Abschnitten konfiguriert werden.
Abschnitt „Query“:
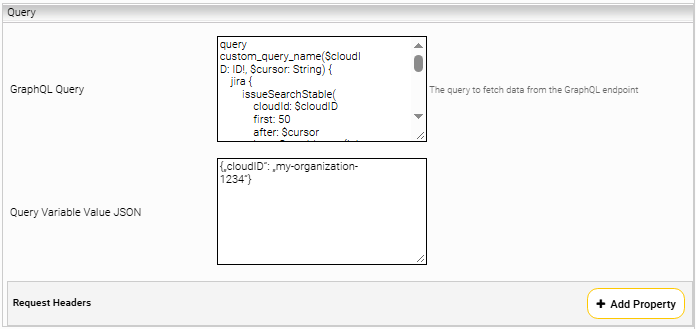
Einstellung | Eingabe |
GraphQL Query | Wie definiert im vorherigen Kapitel “Query”: query custom_query_name($cloudID: ID!, $cursor: String) { jira { issueSearchStable( cloudId: $cloudID first: 50 after: $cursor issueSearchInput: {jql: "project = 'DEV'"} ){ totalCount edges { node { summary } } pageInfo { hasNextPage endCursor } } } } |
Query Variable Value JSON | {„cloudID“: „my-organization-1234“} Statische Variablen (z. B. IDs oder Projektnamen) sollten in der Einstellung „Query Variables“ konfiguriert werden. Hinweis: Dynamische Variablen (z. B. Cursor oder Offsets) dürfen hier nicht definiert werden, da sich ihre Werte während der Ausführung ändern. Unabhängig vom Typ müssen alle Variablen als Parameter innerhalb der Abfrage definiert werden, um sicherzustellen, dass sie während des Crawling-Vorgangs geändert werden können. |
Abschnitt „Pagination“:
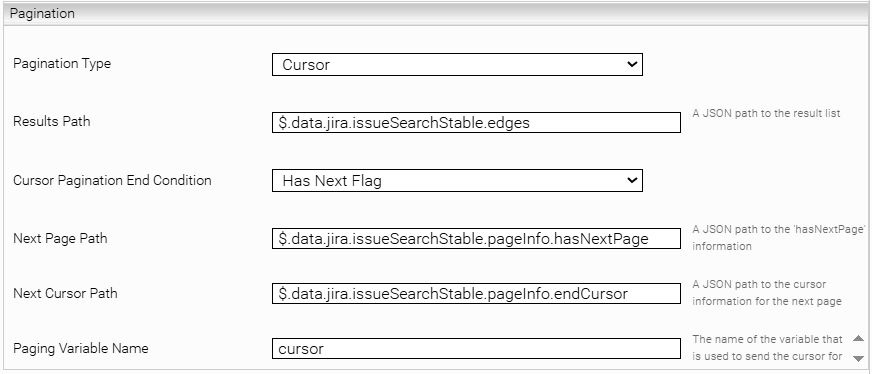
Example value | Description | |
Pagination Type | CURSOR | Das Paging erfolgt über den Cursor |
Results Path | $.data.jira.issueSearchStable.edges | Die „edges“ enthalten das Ergebnis-Array. |
Next Page Path | $.data.jira.issueSearchStable.pageInfo.hasNextPage | Ein „identifier“ prüft, ob es eine nächste Seite gibt. |
Next Cursor Path | $.data.jira.issueSearchStable.pageInfo.endCursor | Der Cursor ruft die nächste Seite auf. |
Paging Variable Name | cursor | Diese Variable wird in der Abfrage definiert und dient dazu, den neuen Cursor einzufügen, der während des Crawl-Durchgangs abgerufen wird. |
Die Mindbreeze Konfiguration ist damit vollständig und kann gespeichert werden.
Offset-basierte Paginierung
Die folgenden Beispiele dienen der Veranschaulichung und enthalten Abfragen und Antworten aus ServiceNow.
Bitte beachten Sie, dass es sich hierbei lediglich um ein Beispiel handelt. Für den tatsächlichen Einsatz im Produktionsbetrieb verwenden Sie bitte stattdessen den speziellen Mindbreeze ServiceNow Connector, um ServiceNow-Dokumente zu crawlen.
Query
query get_knowledge_articles($offset: Int) {
GlideRecord_Query {
kb_knowledge(pagination: {limit: 2, offset: $offset}) {
_results {
sys_id {
value
}
text {
value
}
sys_updated_on {
value
}
sys_created_on {
value
}
}
}
}
}
Die folgenden Konfigurationsoptionen sind im definierten Query:
Konfigurationsoption | Ist im Query definiert als… |
Paging variable name | offset |
Results path | _results |
Ergebnis
Um zu sehen, ob das definierte Query auch das benötigte Ergebnis erzeugt, kann ein beliebiger GraphQL Explorer verwendet werden. Basierend darauf wie das Query definiert ist, wird nur das Query selbst benötigt, um die folgenden Ergebnisse zu erhalten:
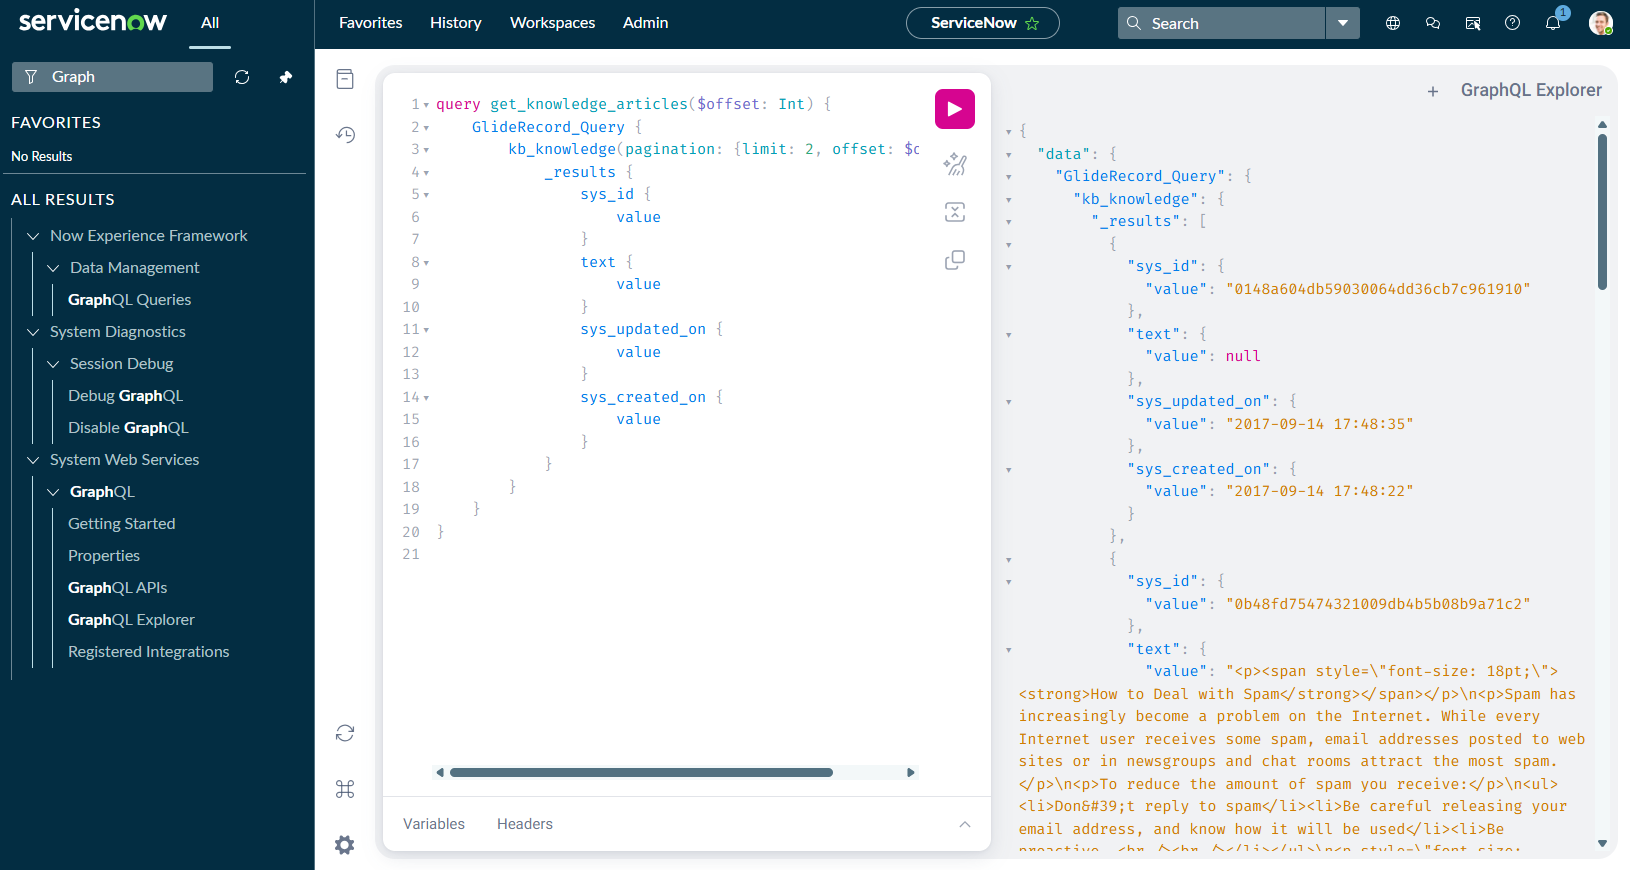
Da das definierte Query die erwarteten Ergebnisse ausgibt, ist der nächste Schritt die Konfiguration des Query und der Offset-basierten Paginierung in Mindbreeze InSpire.
Mindbreeze Konfigurierung
Um die definierte Query und die Offset-basierte Paginierung in Mindbreeze InSpire vollständig zu konfigurieren, müssen die folgenden Einstellungen in den folgenden Abschnitten konfiguriert werden.
Abschnitt „Query“:
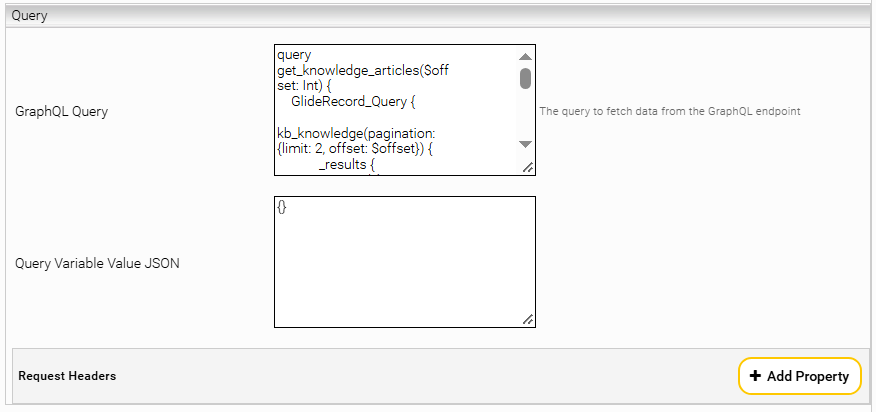
Einstellung | Eingabe |
GraphQL Query | Wie definiert im vorherigen Kapitel “Query”: query get_knowledge_articles($offset: Int) { |
Abschnitt „Pagination“:
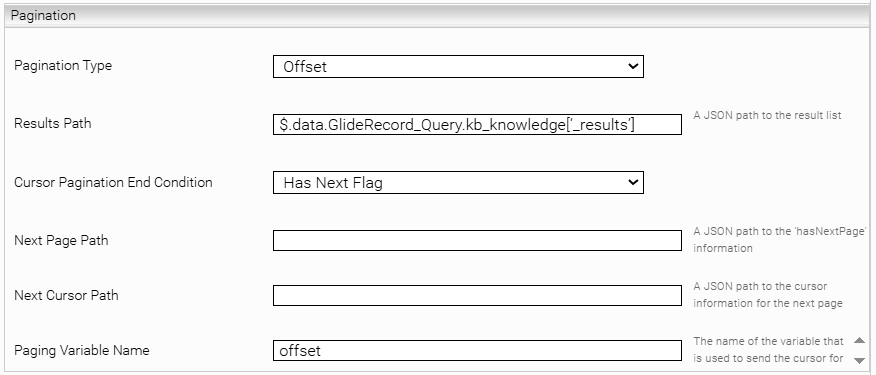
Konfigurationsoption | Beschreibung | |
Pagination Type | OFFSET | Das Paging erfolgt über einen Offset. |
Results Path | $.data.GlideRecord_Query.kb_knowledge[‘_results’] | “_results” enthält das Ergebnisse-Array. |
Next Page Path | Wird nicht verwendet mit Offset-Paginierung. | |
Next Cursor Path | Wird nicht verwendet mit Offset-Paginierung. | |
Paging Variable Name | offset | Diese Variable wird in der Abfrage definiert und dient dazu, den neuen Offset einzufügen, der während des Crawlings berechnet wird. |
Die Mindbreeze Konfiguration ist damit vollständig und kann gespeichert werden.
Beispiele für Pivotierung
„Pivoting“ bezeichnet den Prozess der Umwandlung eines JSON-Arrays in ein JSON-Objekt.
Key/Value Pivotierung
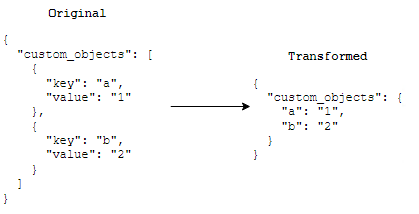
Mindbreeze Konfiguration:
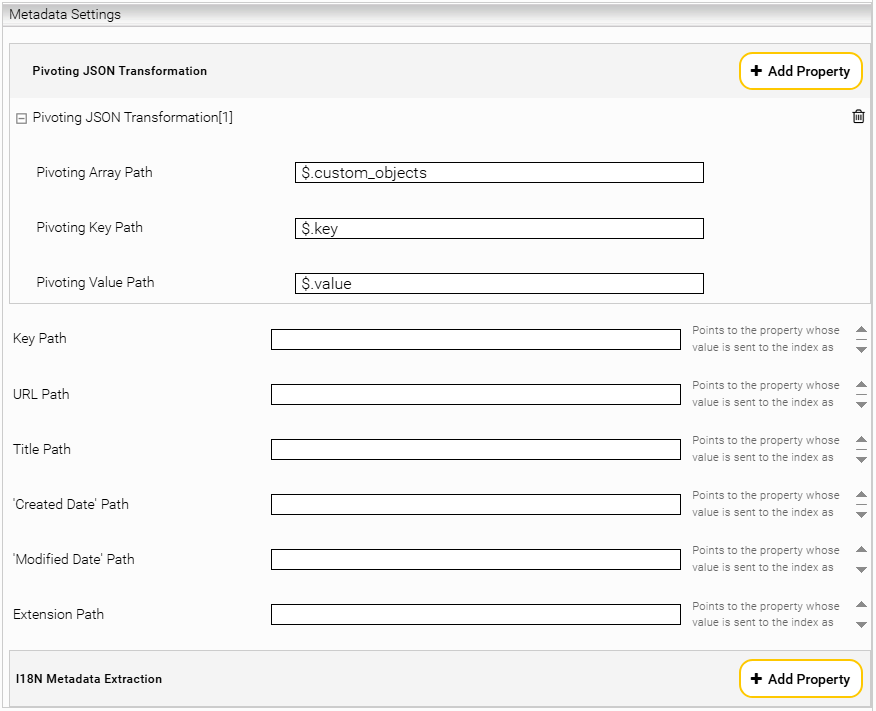
Key Pivoting 1
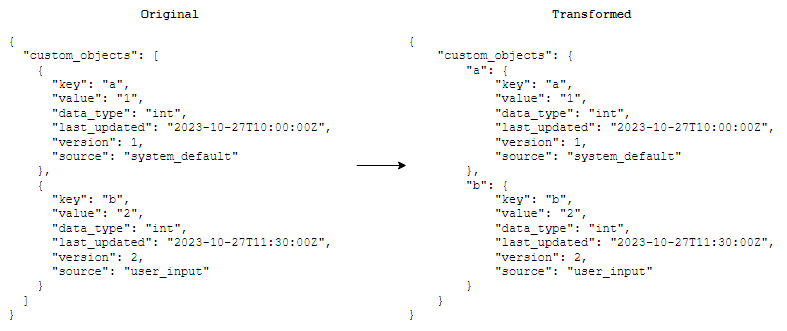
Mindbreeze Konfiguration:
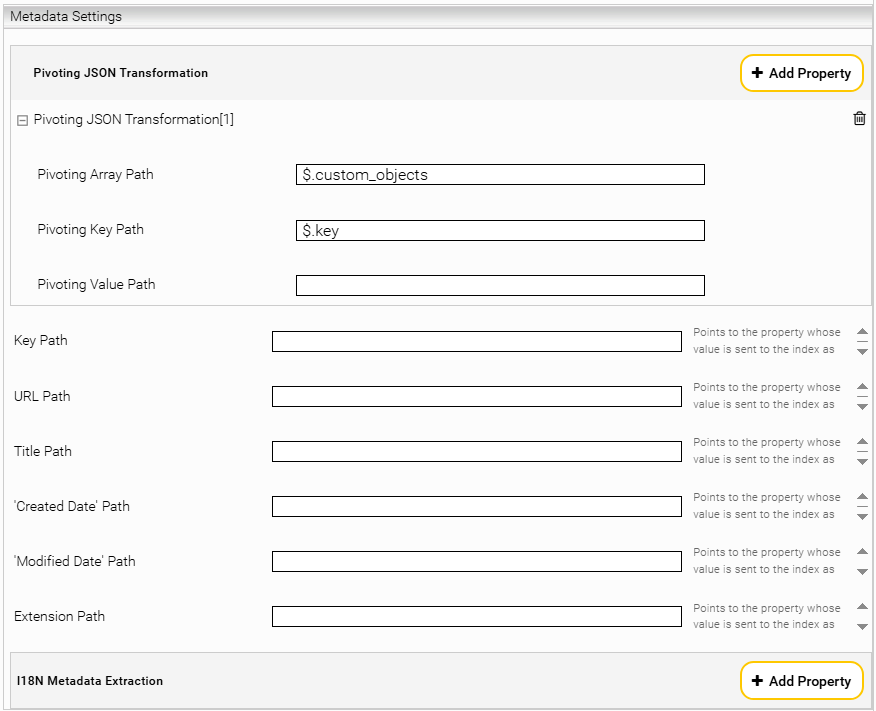
Key Pivoting 2
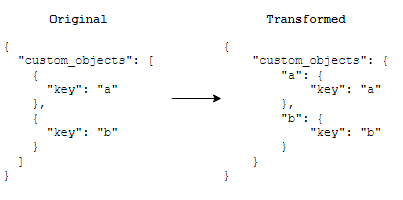
Mindbreeze Konfiguration:
Beispiele für i18n
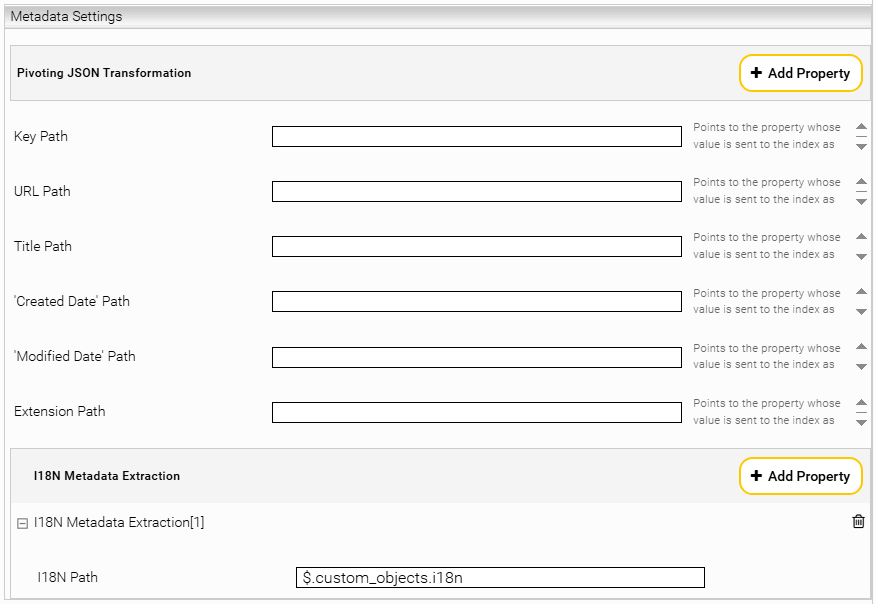
Der Connector unterstützt i18n-Metadaten, die in den Metadaten-Einstellungen konfiguriert werden können. Als i18n-Metadaten werden nur JSON-Objekte unterstützt. Alle Schlüssel und Werte müssen Strings sein, und die Schlüssel müssen dem ISO-639-Standard entsprechen.
i18n Objekt Metadaten
Original:
{
"custom_objects": {
"i18n": {
"en": "Account ID",
"es": "ID de cuenta",
"fr": "ID du compte"
}
}
}
Mindbreeze Konfiguration:
I18N Array Metadaten
Wenn i18n-Metadaten in einem JSON-Array bereitgestellt werden, müssen diese zuerst pivotiert werden, um sie verarbeiten zu können.
Original:
{
"custom_objects": {
"i18n": [{
"lang": "en",
"val": "Account ID"
}, {
"lang": "es",
"val": "ID de cuenta"
}, {
"lang": "fr",
"val": "ID du compte"
}
]
}
}
Mindbreeze Konfiguration für Pivotierung:
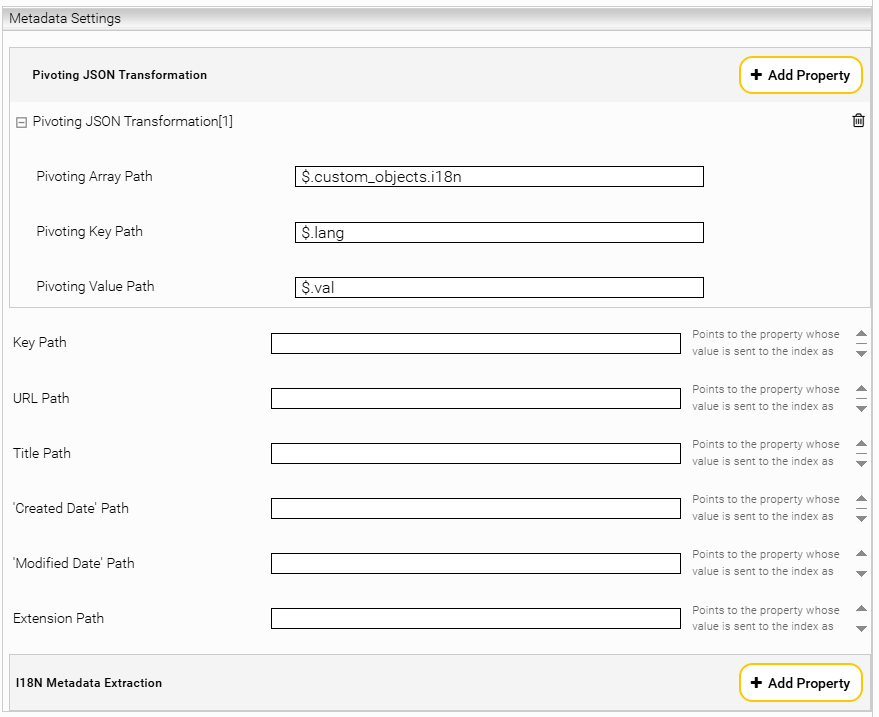
Pivotierungs-Resultat:
{
"custom_objects": {
"i18n": {
"en": "Account ID",
"es": "ID de cuenta",
"fr": "ID du compte"
}
}
}
Mindbreeze Konfiguration für i18n:
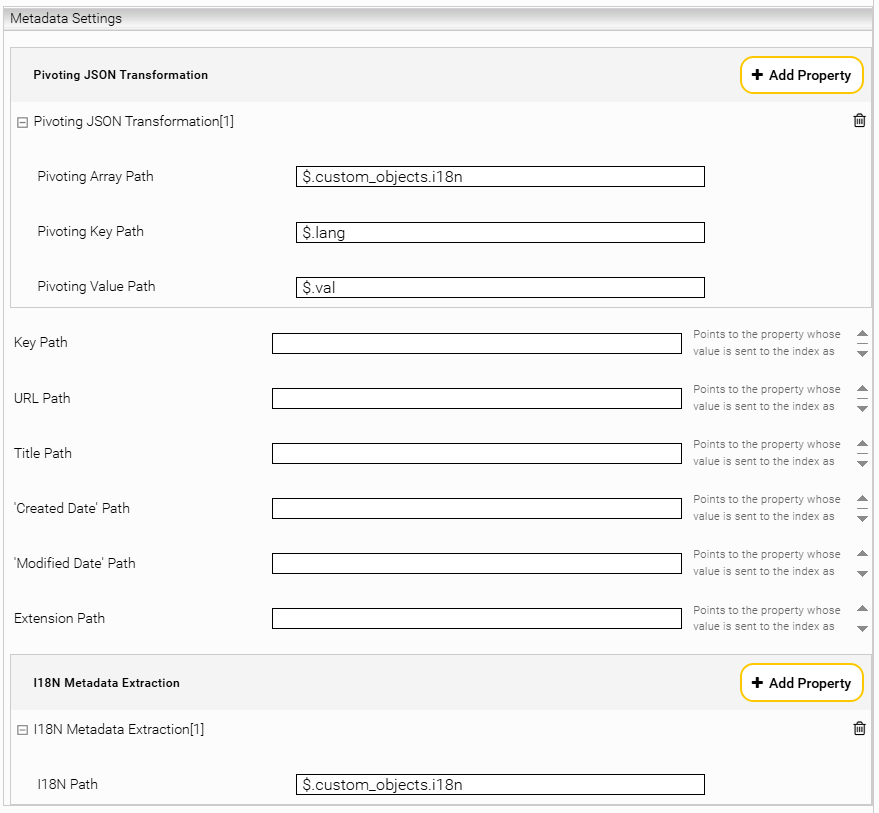
i18n Titel
Wenn i18n Metadaten als Titel-Metadaten (mehrsprachiger Titel) verwendet werden sollen, muss der JSON-Path sowohl als ‚Title Path‘ als auch als ‚I18N Path‘ konfiguriert werden.