

Sure, you can handle it. But should you?
Let our experts manage the tech maintenance while you focus on your business.
Let our experts manage the tech maintenance while you focus on your business.
Konfiguration
Filter Plugins
Einleitung
Im Bereich „Filter Plugins“ der Filter Service Konfiguration sind alle installierten Filter Plugins, die für eine Datei-Erweiterung ausgewählt werden können, verfügbar. Die Erweiterungen werden ohne Berücksichtigung der Groß-/Kleinschreibung abgeglichen.
Im Bereich „Global Filter Plugin Properties“ können diese Filter Plugins konfiguriert werden, wenn eine spezielle Konfiguration benötigt wird. Dazu sollte das entsprechende Plugin von der Drop-Down-Liste ausgewählt und zu der Filterkonfiguration hinzugefügt werden.
Allgemeine Plugin-Einstellungen
Das folgende Feld kann für mehrere Plugins konfiguriert werden.
Number of instances | Legt fest, wie viele Instanzen des Plugins parallel laufen sollen. Standardwert: Lassen Sie das System entscheiden. |
Allgemeine Informationen zu Standard Email Filter (FilterPlugin.POIMsg und FilterPlugin.EML)
E-Mails (Dokumente mit Extension .msg oder .eml) beinhalten üblicherweise mehrere Inhalte. Beispiele für diese Inhalte sind E-Mail Anhänge. Die Standard Email Filter Plugins (FilterPlugin.POIMsg und FilterPlugin.EML) extrahieren E-Mail Anhänge aus den E-Mail Dokumenten. Je nach Extension werden die Anhänge anschließend an andere Filter weitergeleitet (z.B. PDF, DOCX…) welche die weitere Extraktion des Inhalts vornehmen.
Der Inhalt eines E-Mails kann auch in verschiedenen Formaten (teilweise sogar nebeneinander) vorliegen. Beispiele sind Plaintext- (TXT), HTML- oder Richtext- (RTF) und HTML-Format E-Mails. Wenn vorhanden, wird HTML bevorzugt und an den für HTML konfigurierten Filter weitergeleitet. Ansonsten wird RTF oder TXT als Inhalt verwendet.
Die einzelnen Teile von E-Mails (Anhänge, Inhalte) werden auch als MIME-Parts bezeichnet. Diese MIME-Parts können je nach E-Mail Anwendung, Betriebsystem und Standorteinstellungen verschiedene Character Encodings innerhalb desselben E-Mails besitzen. Die Standard Email Filter (FilterPlugin.POIMsg und FilterPlugin.EML) normalisieren diese Character Encodings auf UTF-8. Dieses Verhalten lässt sich bei Bedarf auch anpassen.
FilterPlugin.POIMsg
Folgende Felder können für POIMsg Filter Plugin konfiguriert werden:
Feldname | Beschreibung |
Keep Datasource Category Class | Standardmäßig bekommen alle msg Dateien die Category Class „mail“, auch wenn die Datenquelle eine andere Category Class definiert. Um die Category Class von der Datenquelle beizubehalten sollte dieses Feld ausgewählt werden. |
Prefer HTML Meta Tag Character Encoding | Wenn aktiviert, wird der HTML-Inhalt von E-Mails mit dem Character Encoding, welches im HTML meta tag angegeben ist, geparst. Dadurch wird das Character Encoding, welches im MIME-Part angegeben ist, nicht durchgeführt. Standardeinstellung: Deaktivert. |
FilterPlugin.InternalZip
Folgende Felder können für InternalZip Filter Plugin konfiguriert werden:
Feldname | Beschreibung | ||||||
Datasource Metadata Selection Strategy | Die folgenden Optionen stehen zur Verfügung:
|
FilterPlugin.EML
Folgende Felder können für EML Filter Plugin konfiguriert werden:
Beschreibung | |
Prefer HTML Meta Tag Character Encoding | Wenn aktiviert, wird der HTML-Inhalt von E-Mails mit dem Character Encoding, welches im HTML meta tag angegeben ist, geparst. Dadurch wird das Character Encoding, welches im MIME-Part angegeben ist, nicht durchgeführt. Standardeinstellung: Deaktivert. |
Keep MIME Part Character Encoding | Wenn aktiviert, werden die Text- und HTML-Inhalte nicht auf UTF-8 normalisiert, sondern bleiben im ursprünglichen Format. Standardeinstellung: Deaktivert. |
FilterPlugin.MetadataOnly
Der FilterPlugin.MetadataOnly dient als Fallback-Filter, wenn kein anderer Filter das Dokument filtern konnte und "Probing" aktiviert ist. Mit diesem Filter ist es möglich, Dokumente zu indizieren, die mit anderen Filtern nicht indiziert werden können.
Das FilterPlugin.MetadataOnly reicht Dokumente an den Index weiter, ohne den Inhalt selbst zu filtern. Das bedeutet, dass keine inhaltlichen Metadaten sowie keine Vorschau für das Dokument erstellt werden. Metadaten wie Dateiname, Datum, Autor etc. werden trotzdem an den Index übergeben.
Dieser Filter kann beispielsweise verwendet werden, um verschlüsselte PDF-Dateien zu indizieren. Ohne dieses Plugin (und ohne aktiviertes „Probing“) werden verschlüsselte PDF-Dateien vom Filter verworfen und nicht an den Index weitergeleitet, da der Filter keinen Zugriff auf den Inhalt des PDFs hat. Wenn dieser Filter und "Probing" für die gewünschte Dateierweiterung aktiviert ist, filtert der gewählte PDF-Filter wie gewohnt unverschlüsselte PDF-Dateien weiter. Verschlüsselte PDF-Dateien werden stattdessen durch den MetadataOnly-Filter verarbeitet und können in der Suche gefunden werden, allerdings ohne Inhalt.
Standardmäßig ist dieser Filter für alle Dateierweiterungen aktiviert, die standardmäßig aktiviert sind (z.B.: HTML, txt, pdf etc.) verarbeitet aber nur Objekte, wenn auch „Probing“ für die gewünschten Erweiterungen aktiviert ist. Für alle nicht standardmäßig aktivierten Erweiterungen muss der Filter manuell aktiviert werden, indem er ausgewählt wird.
Folgende Felder können für das MetadataOnly Filter Plugin konfiguriert werden:
Feldname | Beschreibung |
Is enabled | Kann verwendet werden, um den Filter zu deaktivieren. Standardeinstellung: Aktiviert. |
FilterPlugin.PDFPreviewFPDFFilter
Das FilterPlugin.PDFPreviewFPDFFilter wird verwendet, um Metadaten und Inhalte aus PDF-Dokumenten zu extrahieren. Der Inhalt ist mit Annotationen versehen, die dann beispielsweise für Features wie „Springen zu einer bestimmten Seite in der Dokumentenvorschau“ und zum Gruppieren von Antworten nach Seiten verwendet werden.
Die folgenden Felder können für das PDFPreviewFPDFFilter-Plugin konfiguriert werden:
Feldname | Beschreibung |
Disable Thumbnails | Wenn diese Option aktiviert ist, wird die Erstellung eines Thumbnail für das Dokument deaktiviert. Standardeinstellung: False (Miniaturansichten werden erstellt). |
Disable Preview Content | Wenn diese Option aktiviert ist, wird die Erstellung einer vollständigen Vorschau des PDF-Dokuments aus den Suchergebnissen deaktiviert. In diesem Fall wird in der Vorschau nur eine Zusammenfassung des Inhalts angezeigt. Standardeinstellung: False (vollständige Vorschauen sind verfügbar). |
Extract Links | Wenn diese Option aktiviert ist, extrahiert der Filter das Ziel von externen Links in PDF-Dokumenten. Wenn die HTML Entity Recognition für HTML-Links aktiv ist (siehe <>), werden auch Entities extrahiert. Standardeinstellung: Deaktiviert |
Max Layout Annotations Per Page | Maximale Anzahl der als Annotation zu extrahierenden Textfelder pro Seite. Standardwert: 0Default value: 0 |
Thumbnail Width | Maximale Breite des Thumbnails (in Punkt). Hinweis: Das Seitenverhältnis der Seite bleibt erhalten. Geben Sie nicht gleichzeitig eine maximale Höhe und eine maximale Breite an. Standardwert: 200pt |
Thumbnail Height | Maximale Höhe des Thumbnails (in Punkten) Hinweis: Das Seitenverhältnis der Seite bleibt erhalten. Geben Sie nicht gleichzeitig eine maximale Höhe und eine maximale Breite an. Standardwert: 200pt |
Extract pages as images | Wenn diese Einstellung aktiviert ist, wird für jede Seite des PDF-Dokuments ein Bild generiert. Die generierten Bilder der Seiten können dann zusammen mit den Antworten aus der Ähnlichkeitssuche abgerufen werden. Um die Bilder abzurufen, muss die Client-Service-Einstellung „Enable Answer Images“ aktiviert sein. Die Bilder werden dann im „api.v2.search“-Response unter „answers[].text.pages[]“ zurückgegeben. Weitere Informationen finden Sie unter api.v2.search Schnittstellenbeschreibung - answers.text.pages. Standardeinstellung: Deaktiviert |
Resolution (DPI) for the extracted page images | Definiert die Auflösung der generierten Bilder der Seiten in „Dots per Inch“ (dpi). Standardwert: 96 dpi |
PDF Meta Keys (in Addition to Defaults) | Zusätzliche zu extrahierende PDF-Metadaten, getrennt durch Semikolons. Standard-Metadaten (title, author, subject, keywords, creator, producer, creation date, modification date) werden standardmäßig extrahiert, es ist nicht notwendig, sie hinzuzufügen. Standardwert: Keine |
Die Größen werden in Punkten angegeben (1 Punkt = 1/72 Zoll = ca. 0,3528 mm).
FilterPlugin.OfficeDocumentToPDFContentFilter
Mit dem Filter Plugin „OfficeDocumentToPDFContentFilter“ werden Microsoft Office Dokumente für die PDF-Vorschau vorbereitet.
Dieses Filter-Plugin ist standardmäßig deaktiviert bzw. muss explizit aktiviert werden.
Das Filter Plugin kann auf folgende Dateiendungen angewandt werden:
Dateiendung | |
Microsoft Word, LibreOffice Writer oder Google Text und Tabellen | odt |
LibreOffice Writer | sxw |
LibreOffice-Suite |
|
ArcScene | sxd |
Microsoft Windows Wordpad, Mac Textedit | rtf |
Microsoft Word |
|
Microsoft PowerPoint |
|
Microsoft Excel |
|
Microsoft Visio |
|
Steinberg Cubase, Imageline FL Studio und Audacity | vst |
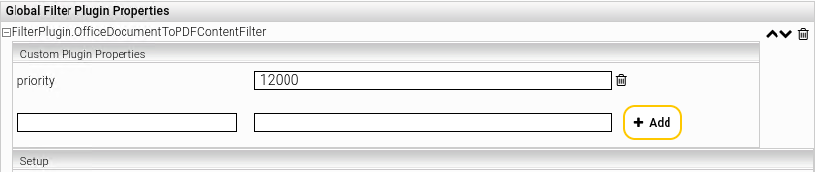
Folgende Einstellungen stehen zur Verfügung:
Beschreibung | Beispiel | |
Custom Plugin Properties | ||
priority | Gibt die Reihenfolge an in der die Plugins ausgeführt werden. Je höher die angegebene Zahl ist, umso höher ist die Priorität und umso früher wird das Plugin ausgeführt. Die Nutzung dieser Einstellung wird für Anwendungsfälle empfohlen, wo die Anwendung von verschiedenen Plugins auf verschiedene Dateiformate im Detail gesteuert werden soll. | 1947 |
Setup | ||
Number of LibreOffice Instances | Definiert die Anzahl der Instanzen, die gestartet werden sollen. Wenn nicht gesetzt, wird ein Standard Wert angenommen, der im allgemeinen Fall ausreichend ist. | 3 |
Run as | ||
User name | Diese Einstellung wird nicht mehr verwendet. | - |
Password | Diese Einstellung wird nicht mehr verwendet. | - |
PDF-Vorschau für alle verfügbaren Dateitypen aktivieren
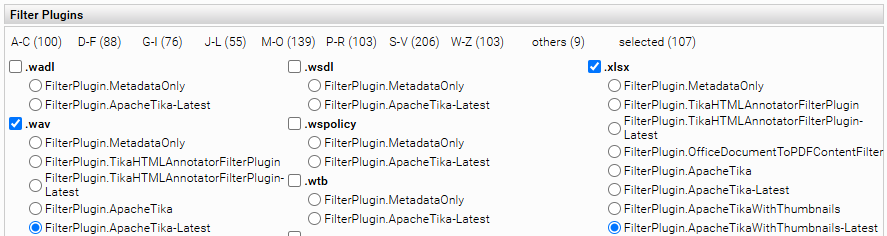
Standardmäßig wird das Filter-Plugin „FilterPlugin.ApacheTikaWithThumbnails-Latest“ für Microsoft Office Dokumente verwendet. Um das Filter-Plugin „FilterPlugin.OfficeDocumentToPDFContentFilter“ vorzureihen und dadurch eine PDF-Vorschau zu erzeugen, muss die Priorität des FilterPlugin.OfficeDocumentToPDFContentFilter auf einen Wert größer als 11100 gesetzt werden. Dies kann man in der Einstellung „priority“ konfigurieren:
PDF-Vorschau für einen oder mehrere Dateitypen aktivieren
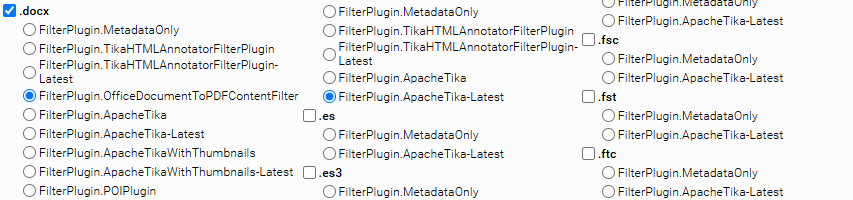
Um die PDF-Vorschau für einen oder mehrere bestimmte Dateitypen zu aktivieren, kann man in den Filtereinstellungen das Filter-Plugin „FilterPlugin.OfficeDocumentToPDFContentFilter“ für einen bestimmten Dateitypen aktivieren (siehe Dateiendung xlsx im Screenshot):
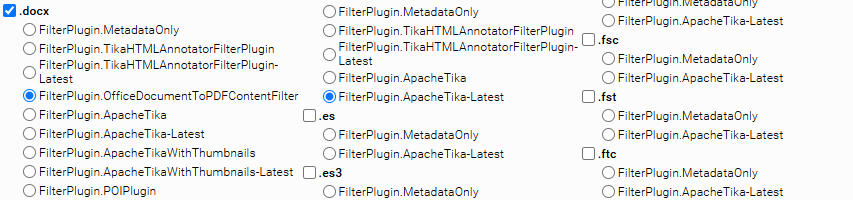
Zum Beispiel können Sie mit einem Klick das Filter-Plugin „FilterPlugin.OfficeDocumentToPDFContentFilter“ für die Dateiendung .docx auswählen:
FilterPlugin.OfficeDocumentToTextAndImages
Das FilterPlugin.OfficeDocumentToTextAndImages dient dazu, Office-Dokumente zu filtern, sie in PDF-Dokumente zu konvertieren, damit sie für die PDF-Vorschau verfügbar sind, und von jeder Seite des konvertierten PDF-Dokuments Bilder zu generieren.
Die generierten Bilder der Seiten können dann zusammen mit den Ergebnissen der Ähnlichkeitssuche abgerufen werden (sofern konfiguriert).
Für mehr Informationen, siehe
FilterPlugin.Pandoc
Das FilterPlugin.Pandoc wird verwendet, um Inhalte aus Microsoft-Office-Dokumenten zu extrahieren.
Dieses Filter-Plugin ist standardmäßig deaktiviert bzw. muss explizit aktiviert werden.
Das Filter Plugin kann auf folgende Dateiendungen angewandt werden:
Dateiendung | |
Microsoft Word, LibreOffice Writer oder Google Text und Tabellen | odt |
Microsoft Windows Wordpad, Mac Textedit | rtf |
Microsoft Word | docx |
Microsoft PowerPoint | pptx |
Microsoft Excel | xlsx |
Für die folgenden Dateiformate erzeugt das Filter-Plugin Seitenannotationen, die sich für Funktionen wie die Gruppierung von Antworten nach Seiten eignen. Dazu muss die Indexeinstellung „Property Expressions For Identifying Page Annotations“ konfiguriert werden.
Applikation (Dateiformat) | Equivalente HTML-Struktur | Indexeinstellung “Property Expressions For Identifying Page Annotations” |
Microsoft PowerPoint (pptx) | <h2 id="slide-123"> |
|
Microsoft Excel (xlsx) | <h2 id="sheet-123"> | regex_match(id, "sheet-\d+") |
Die folgenden Felder können konfiguriert werden:
Feld | Beschreibung |
Pandoc Output Format | Legt das von Pandoc erzeugte Ausgabeformat fest. Das nächste Content-Filter-Plugin in der Content-Filter-Kette wird für das ausgewählte Format (Dateiendung) verwendet, um das Plugin zu filtern. Beispiel: Für „HTML“ wird standardmäßig das Filter-Plugin „FilterPlugin.JerichoWithThumbnails“ verwendet. Standardeinstellung: HTML |
Document Conversion Timeout in Seconds | Legt ein Zeitlimit in Sekunden fest, innerhalb dessen Pandoc ein Dokument verarbeiten soll. Diese Einstellung ist nur wirksam, wenn ein Wert größer als 0 angegeben wird. Sonst gibt es kein Zeitlimit. Standardeinstellung: leer (kein Timeout) |
Enable Pandoc Section Divs | Siehe Pandoc Documentation: --section-divs für mehr Informationen. Standardeinstellung: Aktiviert |
Remove Element Grouping from PPTX Slides | Wenn PPTX-Dokumente gruppierte Elemente enthalten, kann Pandoc diese Elemente nicht verarbeiten und ignoriert sie einfach. Um gruppierte Elemente korrekt herauszufiltern, wird die PPTX-Datei vorverarbeitet und solche Elemente werden entgruppiert, bevor das Dokument mit Pandoc verarbeitet wird. Standardeinstellung: Aktiviert |
FilterPlugin.CommonMarkPlugin
Das Filter-Plugin „FilterPlugin.CommonMarkPlugin“ dient dazu, Inhalte aus Markdown-Dateien zu extrahieren. Es implementiert die CommonMark-Spezifikation der Markdown-Sprache (https://commonmark.org/). Außerdem implementiert es die Erweiterung „Github Flavored Markdown“ für Tabellen (https://github.github.com/gfm/#tables-extension-).
Dieses Filter-Plugin ist standardmäßig für die folgenden Dateiendungen aktiviert:
Applikation | Dateiendung |
Markdown (CommonMark) |
|
Die folgenden Felder können konfiguriert werden:
Feld | Beschreibung | ||||||
Override Encoding | Die Kodierung wird automatisch erkannt, wenn dieses Feld leer gelassen wird. Wenn Sie die automatische Erkennung der Kodierung für alle Dokumente überspringen möchten, können Sie die Kodierung durch einen fest vorgegebenen Wert überschreiben. Beispiel: utf-8 Standardeinstellung: leer | ||||||
Maximum Parsing Depth | Legt eine maximale Tiefe für die Analyse von Markdown-Strukturen fest. Weiterführende Markups werden als reiner Text extrahiert. Standardeinstellung: 100 Achtung: Eine Erhöhung dieses Wertes stellt ein Sicherheitsrisiko dar. Bitte ändern Sie diesen Wert nicht, ohne dies zuvor mit dem Mindbreeze Support abzusprechen. | ||||||
Page Break Marker Pattern | Wenn eine Markdown-Datei Übereinstimmungen mit diesem regulären Ausdruck enthält, wird das Dokument an diesen Stellen in Seiten aufgeteilt. Die Seiten werden als HTML-Annotationen dargestellt, wie sie auch für einen <div class="page">-Marker erzeugt würden. Beispielsweise mit dem konfigurierten Wert \Q<!-- PAGEBREAK -->\E und dem folgenden Input: Page1 Ergibt sich folgendes Ergebnis, dass der gleiche Inhalt ist, wie er aus dem HTML-Dokument erzeugt werden würde: <div class="page">Page1</div> Diese Seiten werden nicht gerendert, können aber für die semantische Suche genutzt werden (zum Beispiel, das Gruppieren von Antworten nach Seiten). Dazu sind die folgenden zusätzlichen Indexeinstellungen erforderlich:
Standardeinstellung: leer | ||||||
Discarded Content Pattern | Definiert einen regulären Ausdruck zur Identifizierung von Inhaltsteilen, die vor der Analyse verworfen werden sollen. Dies kann beispielsweise hilfreich sein, wenn Markdown-Dateien Zeilen enthalten, die fälschlicherweise als Markdown-Markups analysiert würden. Hinweis: Der reguläre Ausdruck kann mehrere Zeilen oder einen Teil einer Zeile abdecken. Hinweis: Die Übereinstimmungen werden verworfen, nachdem das Dokument in Seiten aufgeteilt wurde und bevor es auf Markdown-Syntax analysiert wird. Standardeinstellung: leer |
FilterPlugin.MarkdownPlugin (veraltet)
Dieses Plugin ist veraltet und wird derzeit über „FilterPlugin.CommonMarkPlugin“ aufgerufen.